Funcții
Modele lingvistice explicate clar.
Învață observând și experimentând, de la tokenizare și antrenare la Fine-tuning și sampling. Explorează generarea în 2D din Brain Explorer, folosește Wiki și Explain și urmărește generarea imaginilor în Vision Explorer. Pașii de învățare prezentați nu necesită scripturi proprii.
Nou în 0.2.0
De la concept la un calcul vizibil.
Alpha 0.2.0 extinde parcursul de învățare cu Brain Explorer, Wiki și Vision: înțelege conceptele, fă propriile experimente și examinează calculul pas cu pas.
Brain Explorer
Cum se construiește un răspuns, token cu token?
O vizualizare 2D leagă contextul, blocurile Transformer, probabilitățile și sampling-ul. Redă o înregistrare, pune-o pe pauză sau examinează fiecare pas separat.
Traseele tokenurilor arată Attention, MLP-ul și calea reziduală. Compară două intrări prin același model în A/B și deschide calculul în Visual Explorer când ai nevoie. Poți examina și înregistrări locale Llama/Qwen2 acceptate, inclusiv cache-ul KV atunci când înregistrarea îl permite.
Wiki & Explain
Ce înseamnă termenul de pe acest ecran?
Capitolele de învățare și Wiki cu căutare leagă noțiunile de bază de experimente. Modul Explain explică termenii evidențiați lângă interfața vizibilă.
Explorează tokenuri, Attention, Loss, sampling și modele de imagini în română, engleză sau germană. Explicațiile din paginile acceptate și subiectele Wiki conexe te ajută să înveți fără să pierzi firul experimentului.
Vision & Vision Explorer
Cum devine zgomotul o imagine?
Generează imagini local cu un model acceptat și deschide înregistrarea direct în Vision Explorer. Urmărește eliminarea zgomotului pas cu pas: starea dinainte, predicția zgomotului și starea de după.
Examinează hărți de caracteristici, valori numerice și un punct cross-attention selectat între grila imaginii și tokenurile textuale. Antrenează un model educațional mic de 32 × 32 pixeli pe propriile perechi imagine-descriere sau compară antrenări mici de captioning. Mediile suplimentare, modelele și datele se descarcă numai după confirmare; suportul CPU/GPU și memoria necesară depind de model.
Înțelege ce face modelul tău.
Nu te opri la antrenarea unui model. Explorează cum procesează textul și compară predicțiile între checkpoint-urile salvate.
Explorează pas cu pas
Urmărește tokenurile prin embedding-uri, Attention și ieșire. Laboratorul explică etapele unei treceri înregistrate și arată cum temperatura și filtrele schimbă probabilitățile de selecție.
Compară checkpoint-urile
Compară checkpoint-uri folosind același prompt. Rangurile candidaților înregistrați, barele de diferență și vizualizarea manuală A/B fac vizibile schimbările predicției următorului token. Tabelul poate fi exportat în format CSV.
Antrenează cu exemple
Treci de la pre-antrenare la Fine-tuning: SFT învață din răspunsuri exemplu, DPO din răspunsuri preferate și respinse, iar ORPO combină ajustarea răspunsurilor cu un semnal de preferință. Descarcă seturile de date oferite sau editează propriile exemple.
Urmărește checkpoint-urile
Administrează și redenumește checkpoint-urile salvate, examinează istoricul înregistrat și marcajele Best, reia o rulare împreună cu istoricul Loss sau deschide o stare direct în Sampling ori Chat.
Conectează modele locale și compară răspunsuri
Conectează un folder Safetensors Llama sau Qwen2 acceptat fără să copiezi greutățile. Alege CPU, GPU NVIDIA sau A/B și verifică memoria înainte de încărcare.
Continuă după repornire
Intrările, istoricul Chat și schițele de Fine-tuning sunt restaurate local. Ele sunt stocate necriptat în zona de date a aplicației și pot fi șterse din Setări.
Planifică utilizarea GPU-ului și a memoriei
Verifică necesarul VRAM estimat pentru antrenare sau planul RAM/VRAM al unui model conectat înainte de pornire. Măsurătorile disponibile din timpul rulării rămân separate de estimări.
Rangurile și probabilitățile se referă la candidații înregistrați. „Best” este un marcaj istoric, nu o evaluare a calității. Valorile de memorie sunt estimări. Execuția externă acceptă modele text Llama/Qwen2 fără cuantizare, Custom Code sau multimodalitate. Comparația A/B nu evaluează răspunsurile; textele sunt salvate numai dacă alegi acest lucru.
01 / Date și tokenizer
De la textul sursă la tokenuri
Pregătește seturi de date și inspectează cum tokenizerul împarte textul în tokenuri.
02 / Antrenare și checkpoint-uri
Urmărește progresul
Urmărește antrenarea și validarea, reia rulări din checkpoint-uri și oprește-le opțional după o regulă configurată.
03 / Sampling și Chat
Încearcă modelul
Inspectează rezultate și experimentează cu temperatură, Top-k și Top-p.
04 / Schițe locale
Continuă după repornire
Aplicația restaurează intrările, istoricul conversației și schițele editorului. Acestea sunt stocate local necriptat și pot fi șterse din Setări.
05 / Modele externe și A/B
Conectează Safetensors locale
Conectează un model Llama sau Qwen2 acceptat. Rulează-l pe CPU sau pe un singur GPU NVIDIA ori compară succesiv două răspunsuri.
06 / Visual Explorer
Fă vizibile calculele
Explorează embedding-uri, head-uri Attention individuale, MLP-ul și distribuția următoarelor tokenuri posibile.
07 / Capitole de învățare
Teoria rămâne alături
Citește noțiunile de bază și folosește exemplele interactive din aplicație.
08 / Windows și PyTorch
Lucrează pe calculatorul tău
Interfață Windows nativă cu Engine local de antrenare, configurat separat atunci când este necesar.
Aplicația pe scurt.
Capturi originale ale interfeței în limba engleză din versiunea Alpha anterioară. Capturile prezintă stări exemplificative diferite; valorile de antrenare nu sunt benchmark-uri de performanță.
LEARN
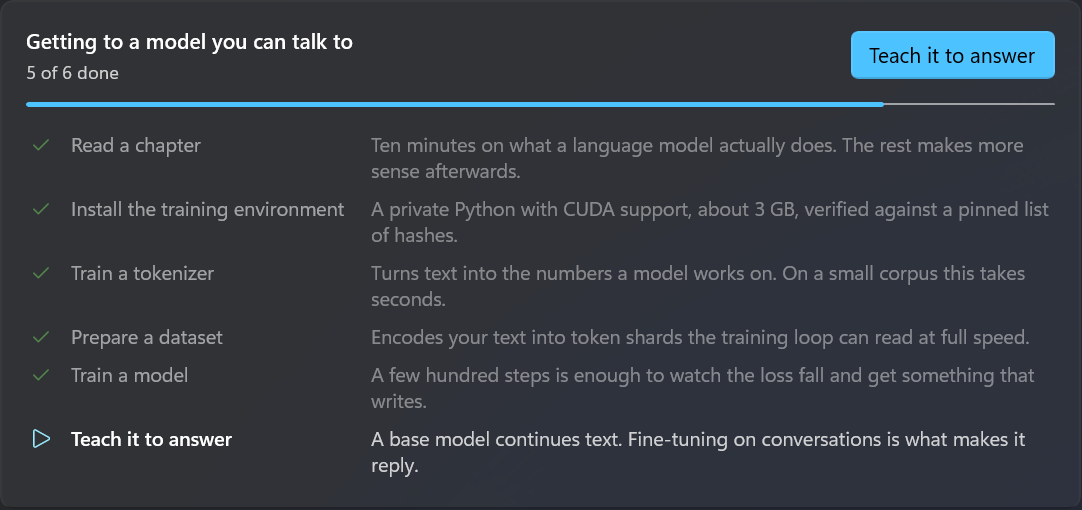
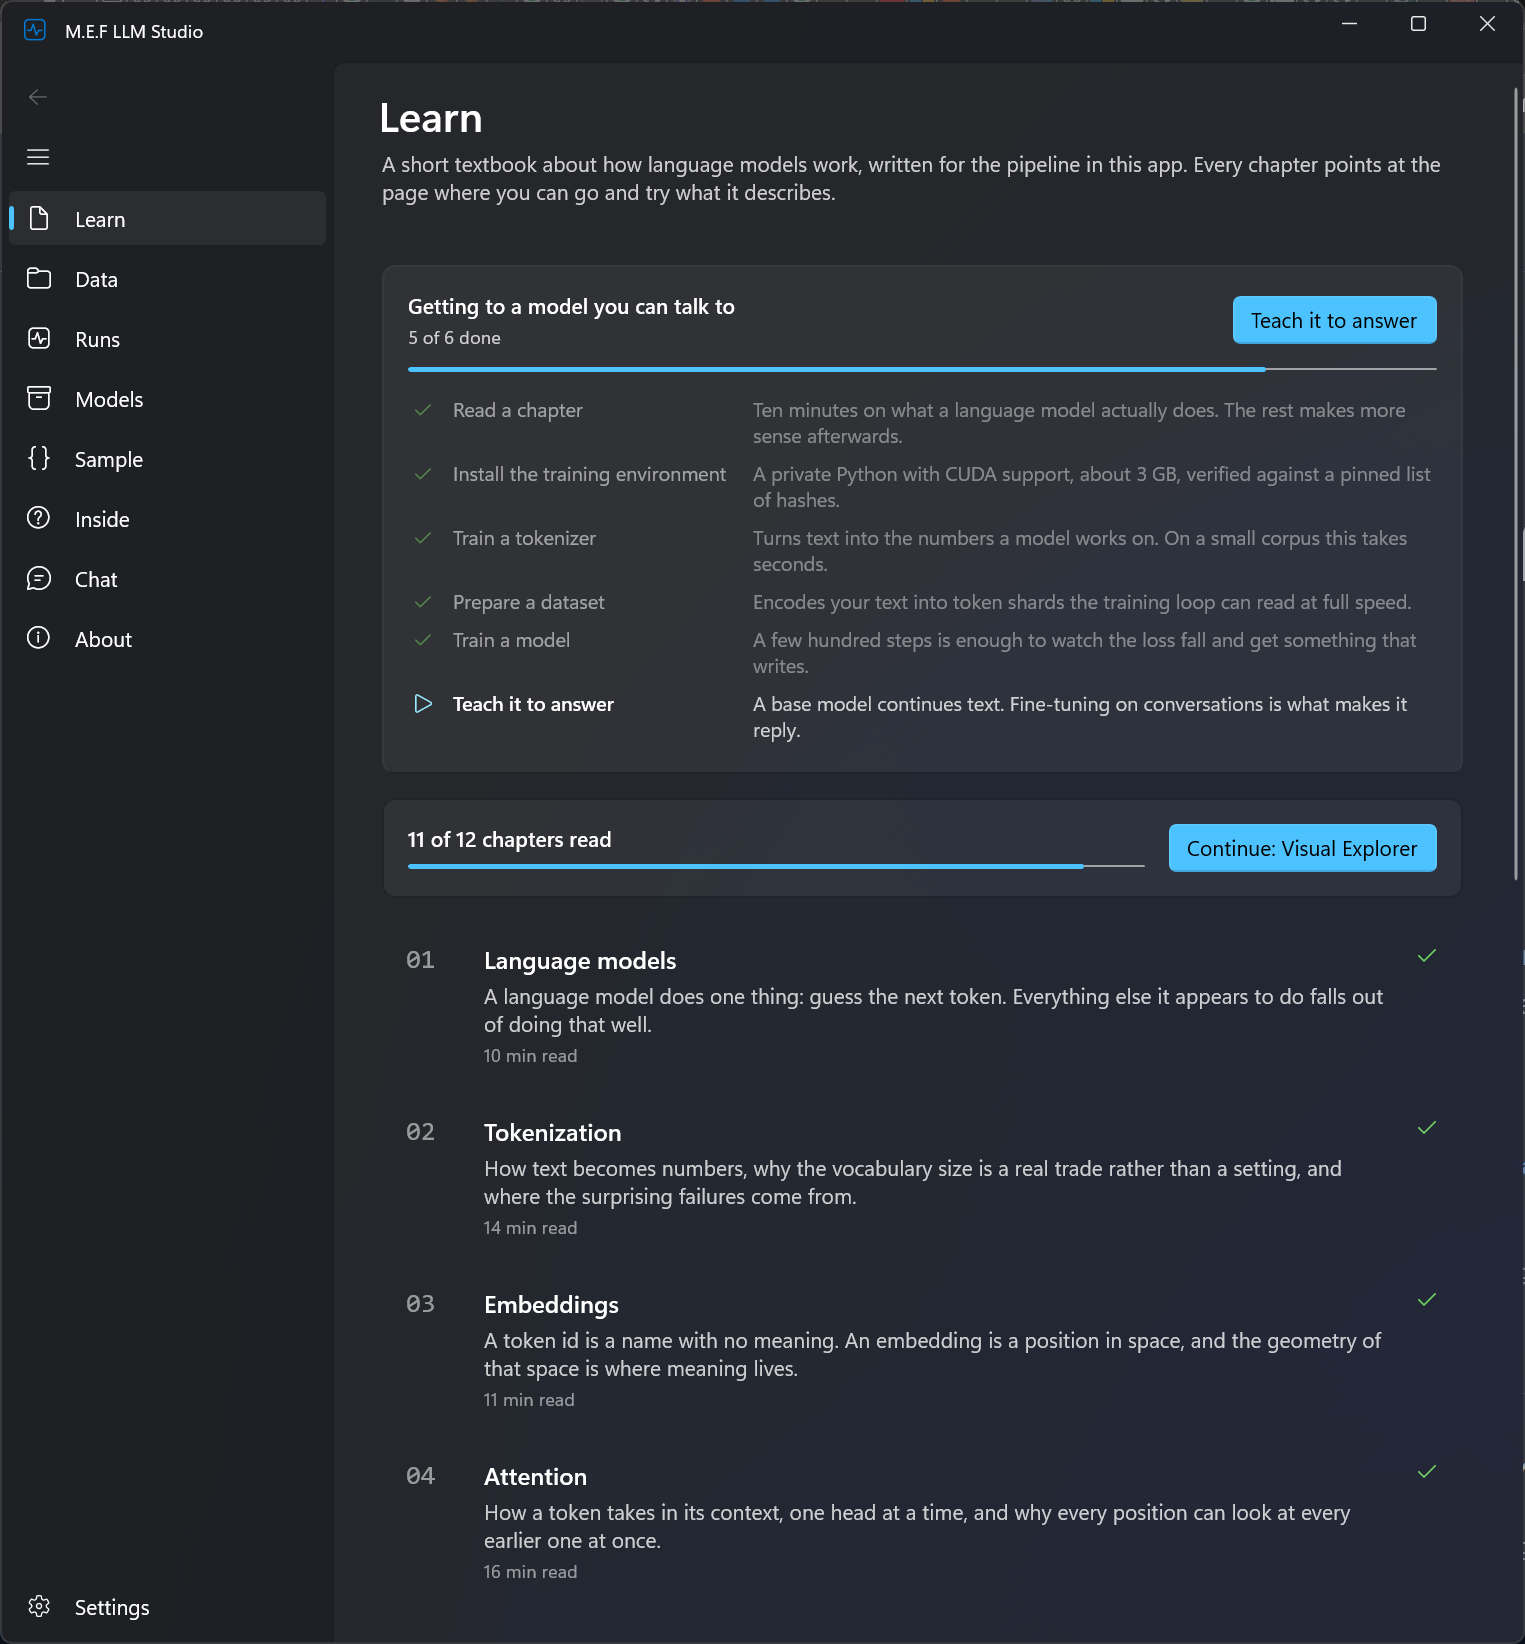
Parcurs de învățare și pașii următori
Prezentarea unește capitolele de învățare și configurarea într-un singur flux de lucru.
Ce poți face:
Citește noțiunile de bază, apoi continuă cu pasul următor: configurarea mediului, pregătirea datelor sau antrenarea.
Captură completă a ferestrei ↗DATA
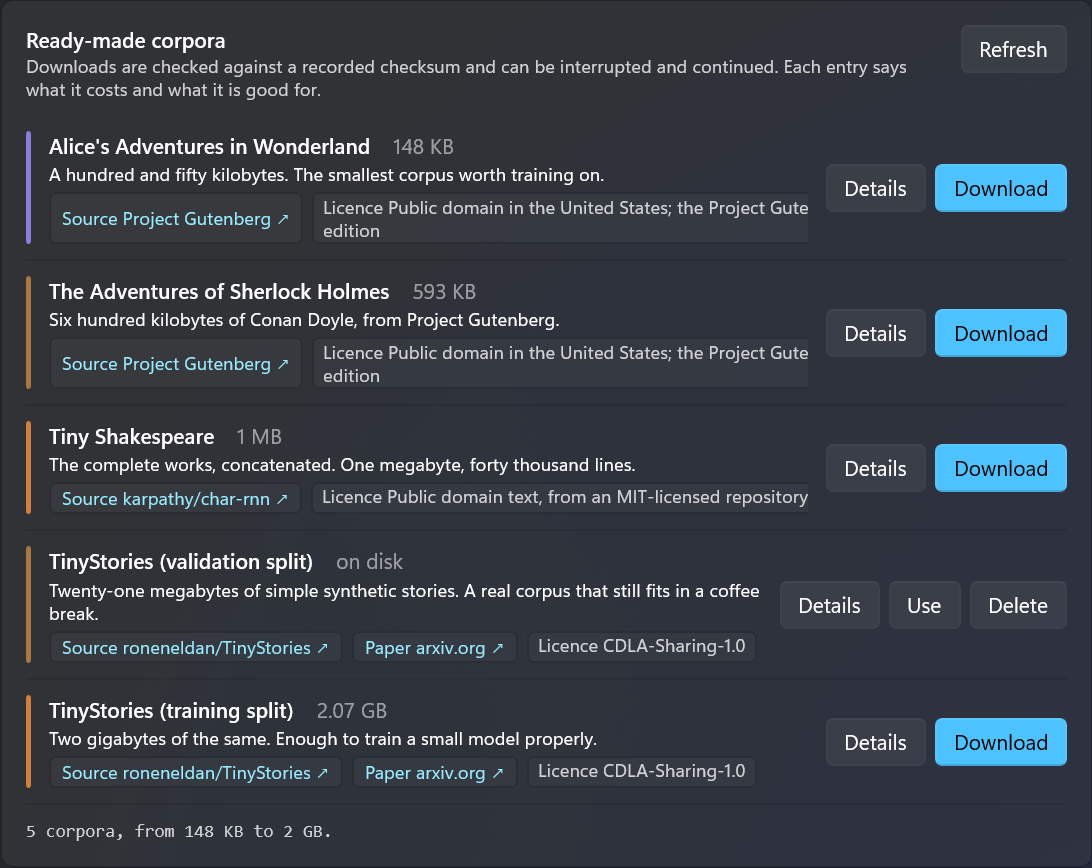
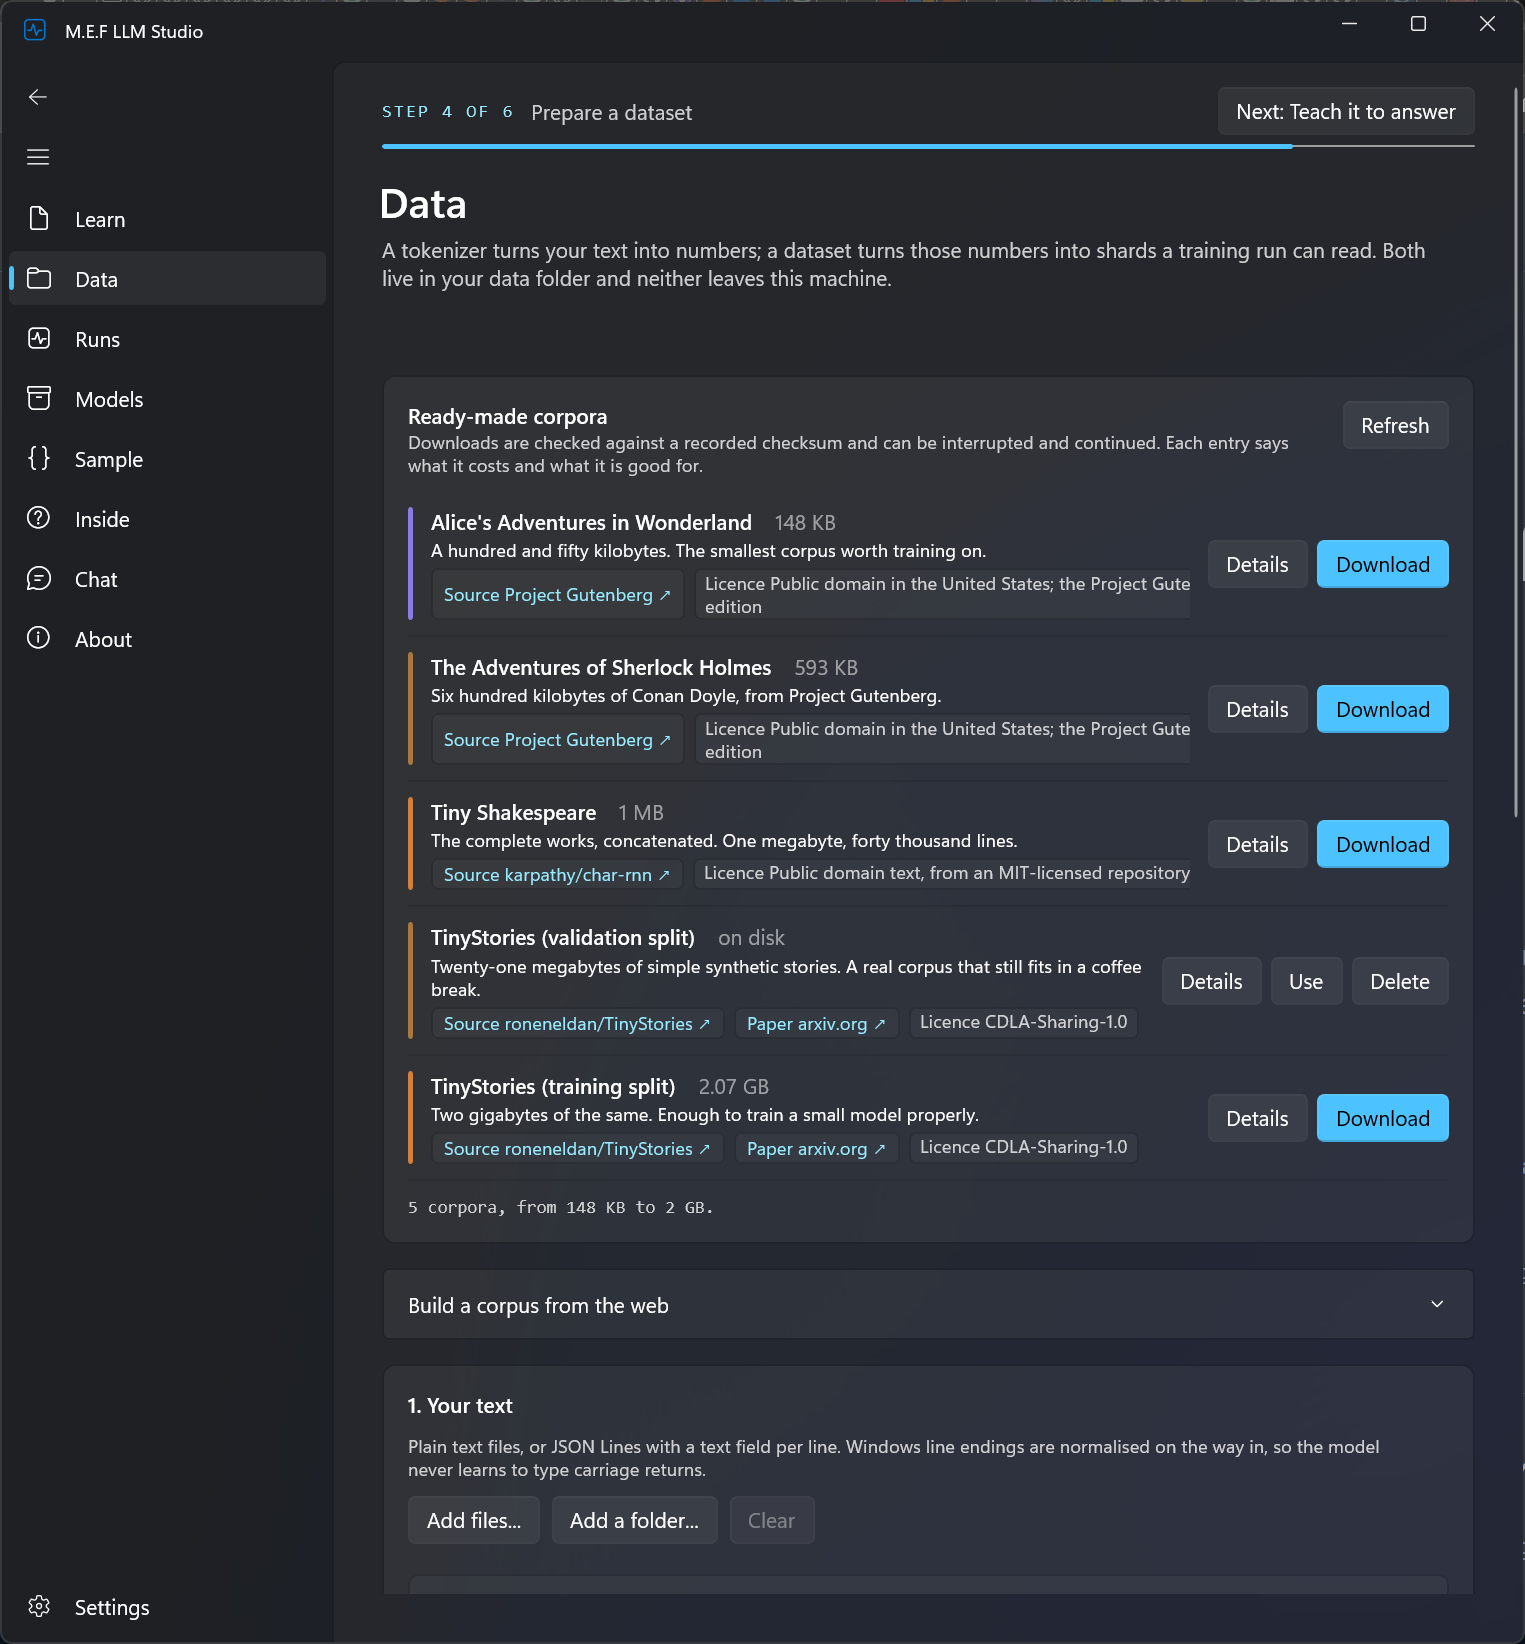
Alege datele de antrenare
Catalogul prezintă colecțiile de texte disponibile împreună cu sursele, dimensiunile și notele de licență.
Ce poți face:
Examinează detaliile și descarcă date potrivite. Verifică condițiile de utilizare ale fiecărei surse.
Captură completă a ferestrei ↗RUNS
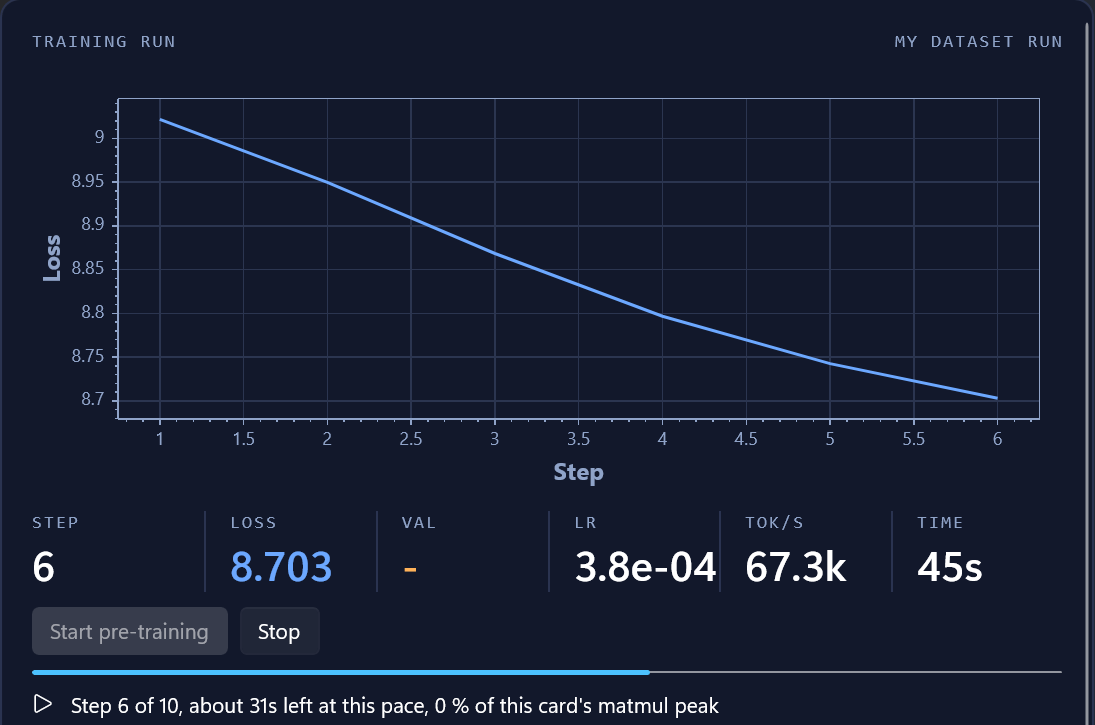
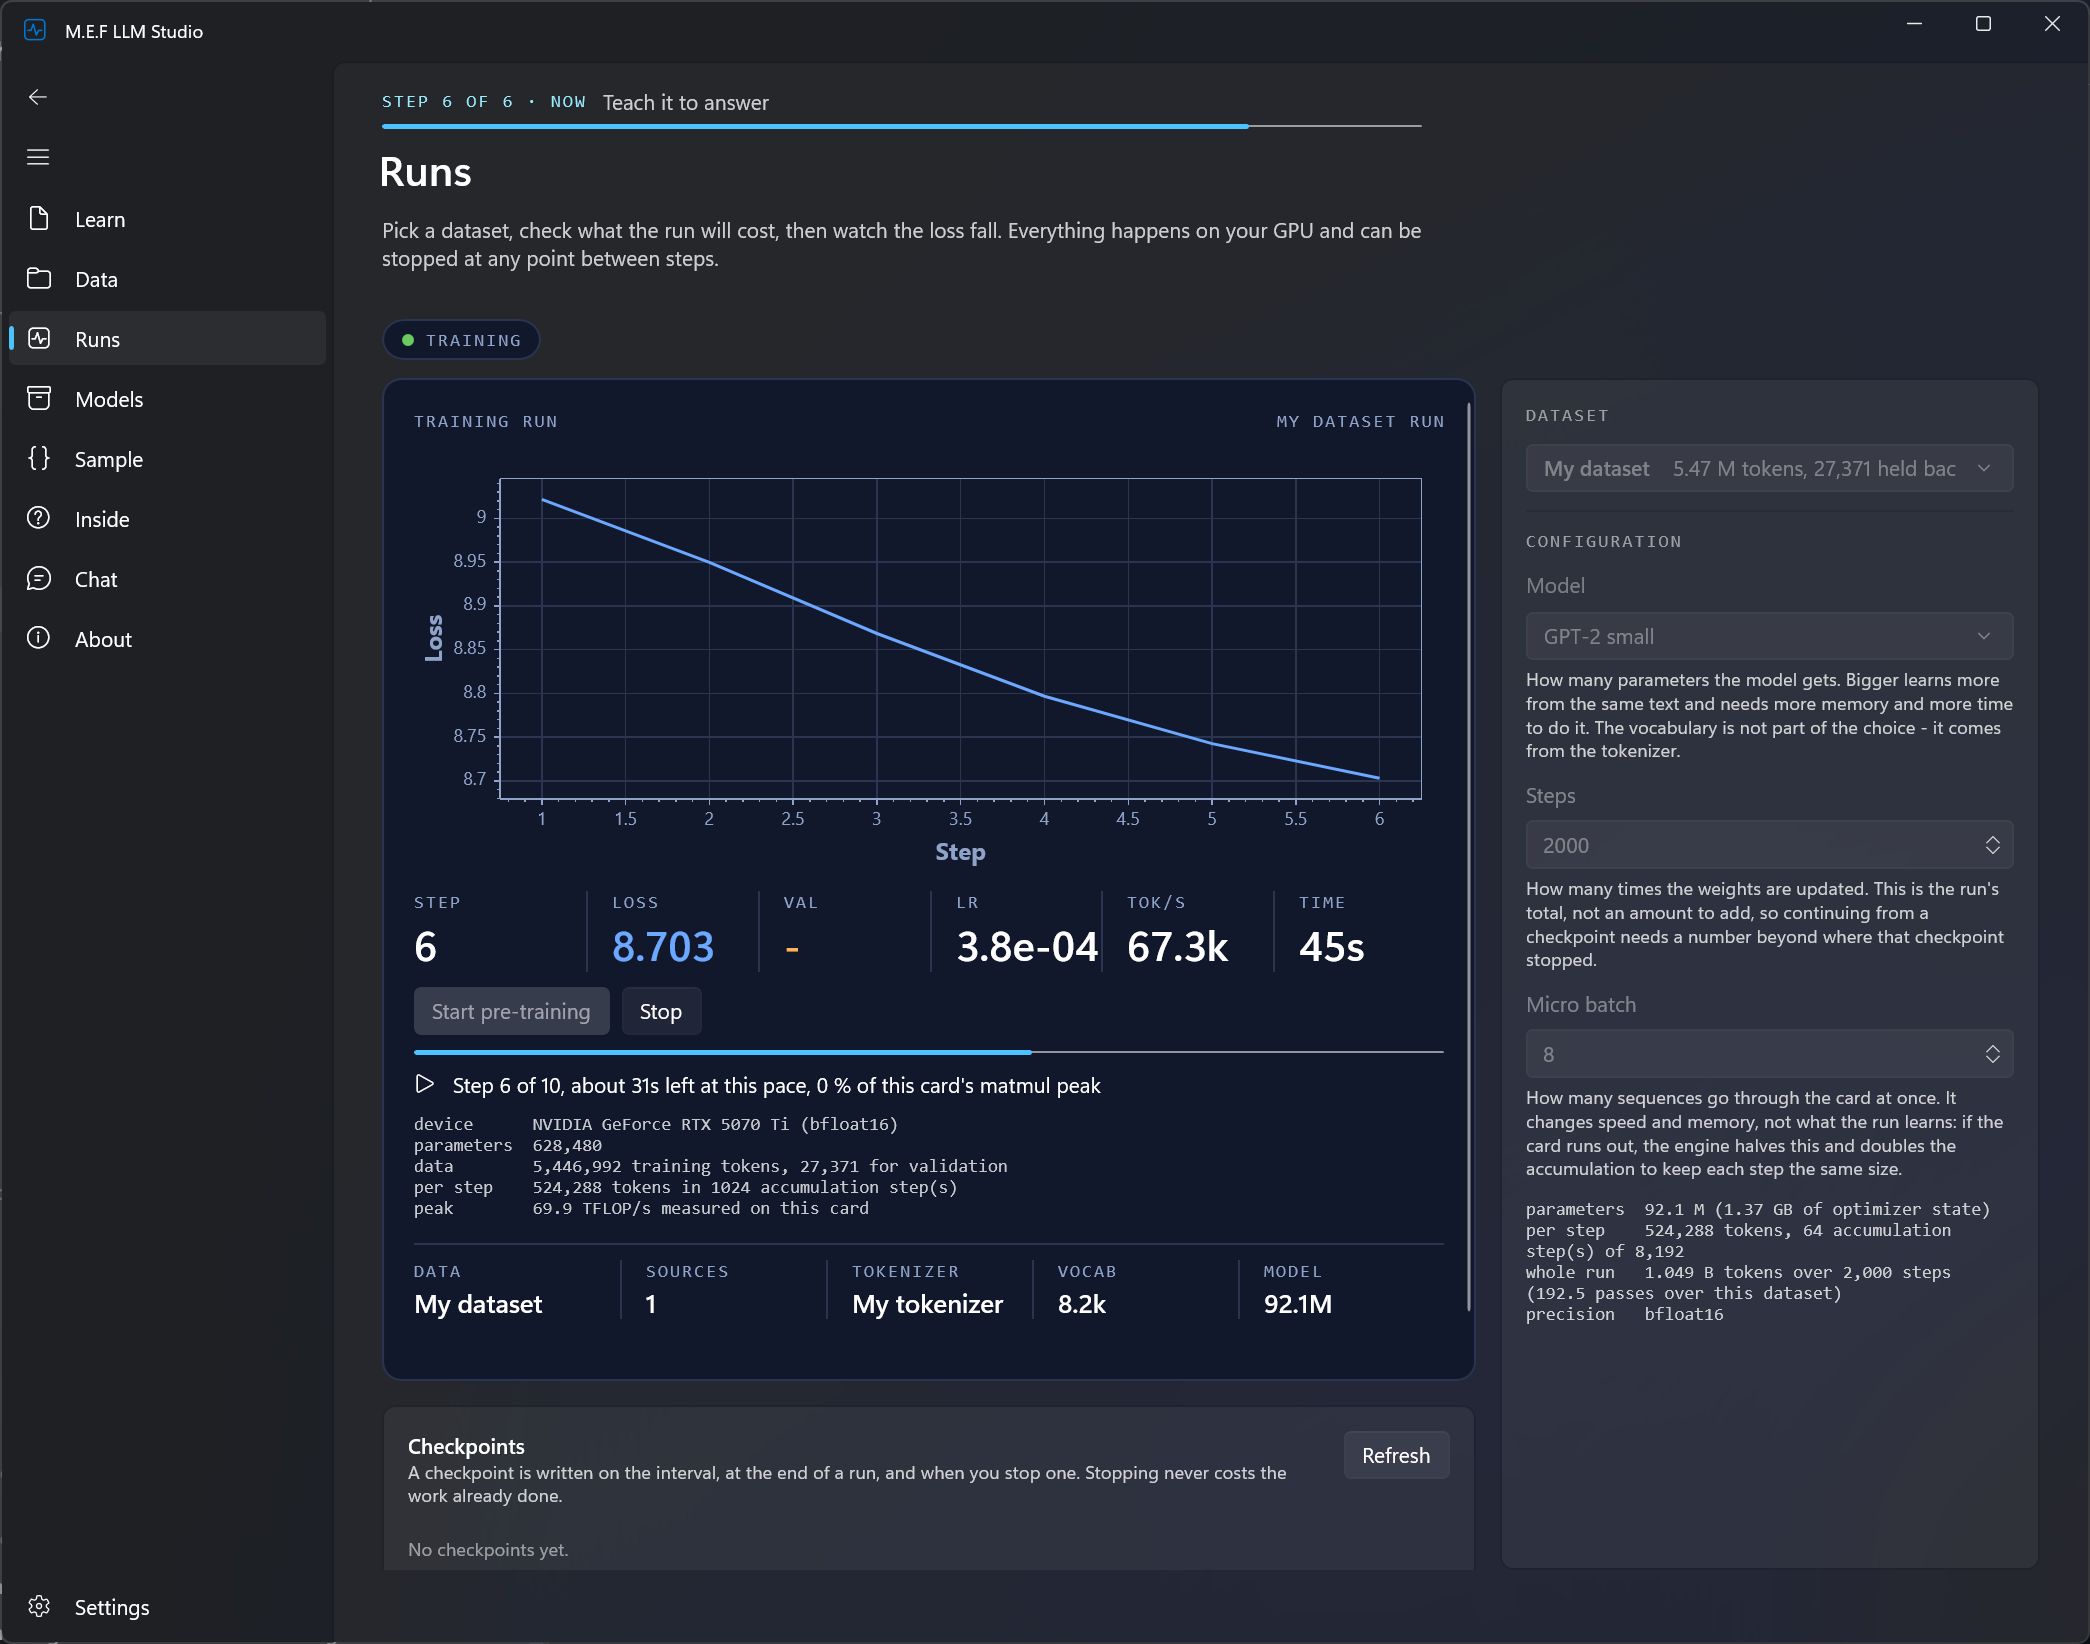
Urmărește o rulare de antrenare
Curba Loss, numărul pasului și timpul scurs arată evoluția rulării.
Ce poți face:
Urmărește rularea și oprește-o dacă este necesar. Valorile afișate sunt exemple, nu o promisiune de performanță.
Captură completă a ferestrei ↗MODELS
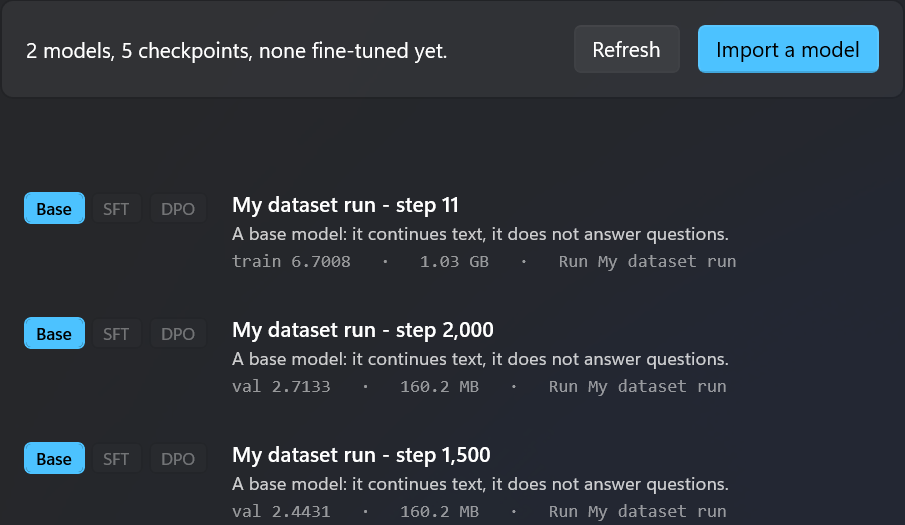
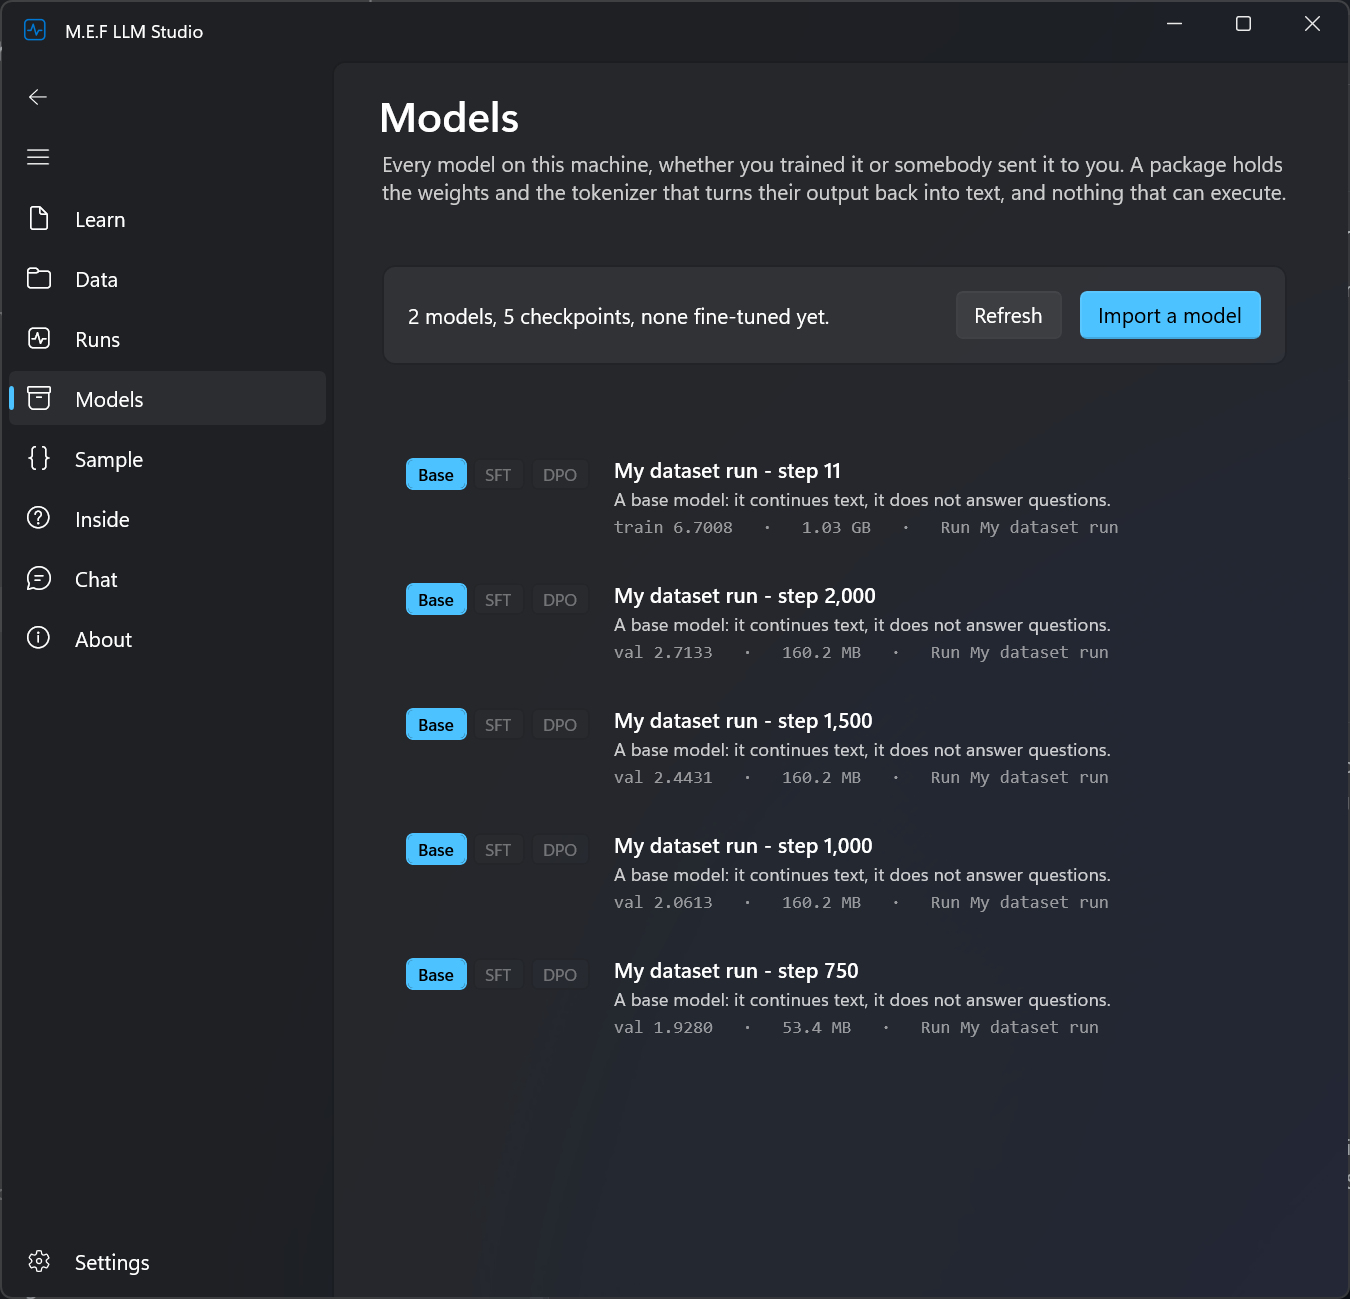
Modele și checkpoint-uri
Prezentarea modelelor organizează stările salvate și indică etapa lor de antrenare.
Ce poți face:
Alege o stare potrivită pentru următoarea evaluare sau importă un pachet de model.
Captură completă a ferestrei ↗CHAT
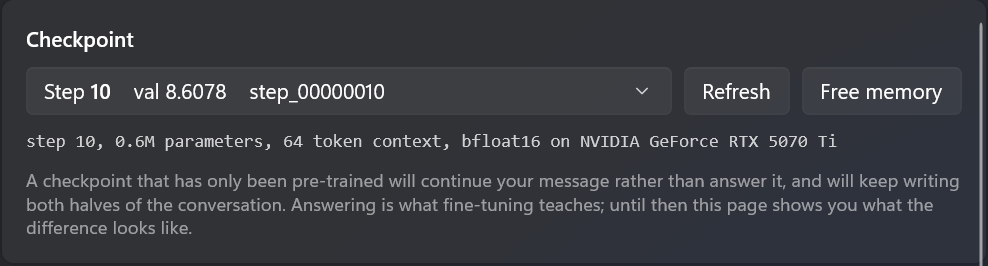
Alege un checkpoint pentru Chat
Selectorul arată ce stare a modelului folosește Chat.
Ce poți face:
Alege un checkpoint, actualizează lista sau eliberează memoria ocupată de model.
Captură completă a ferestrei ↗CHAT
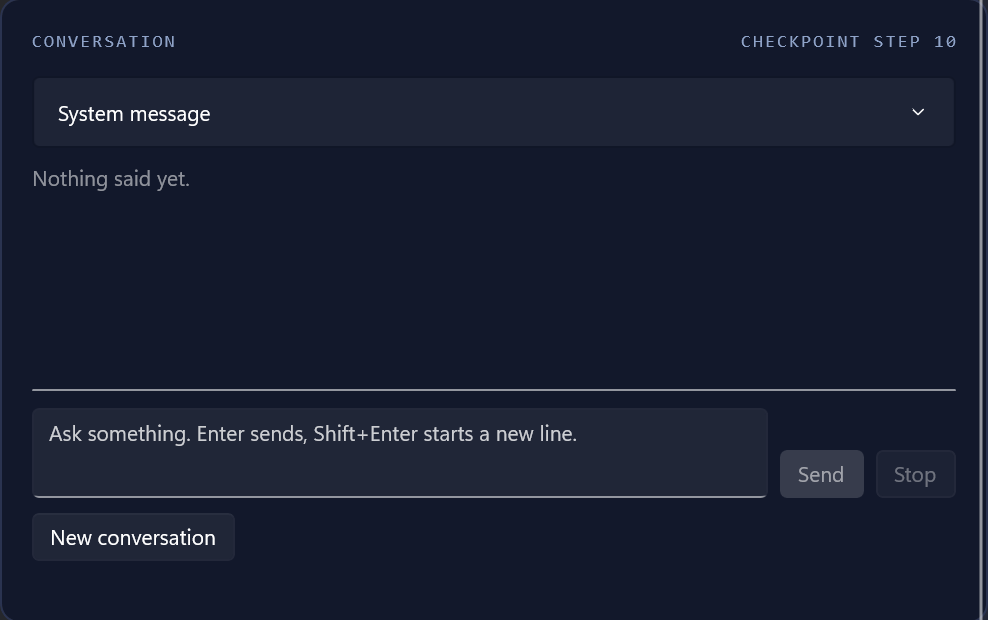
Încearcă rezultatele modelului
Zona de conversație afișează intrările și textul generat. Cele două capturi prezintă stări diferite.
Ce poți face:
Încearcă modelul. Un model de bază pre-antrenat continuă textul; răspunsurile utile necesită o antrenare potrivită.
Captură completă a ferestrei ↗CHAT
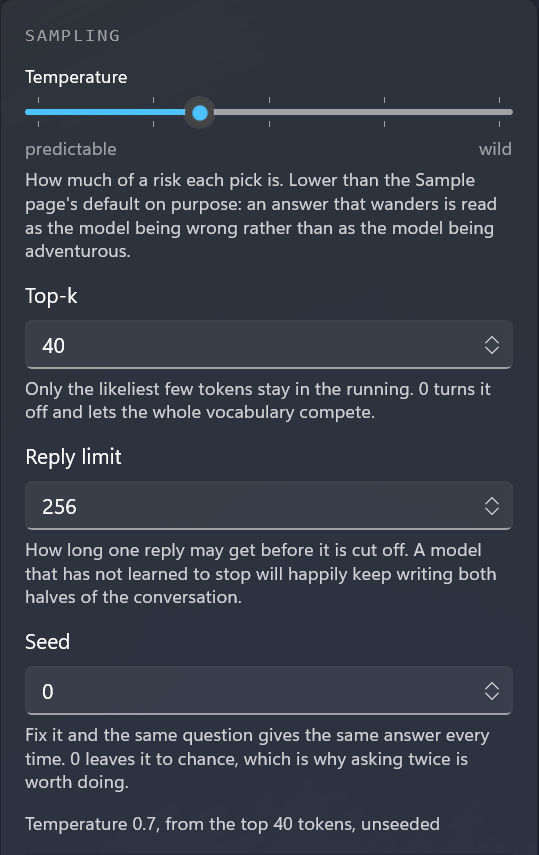
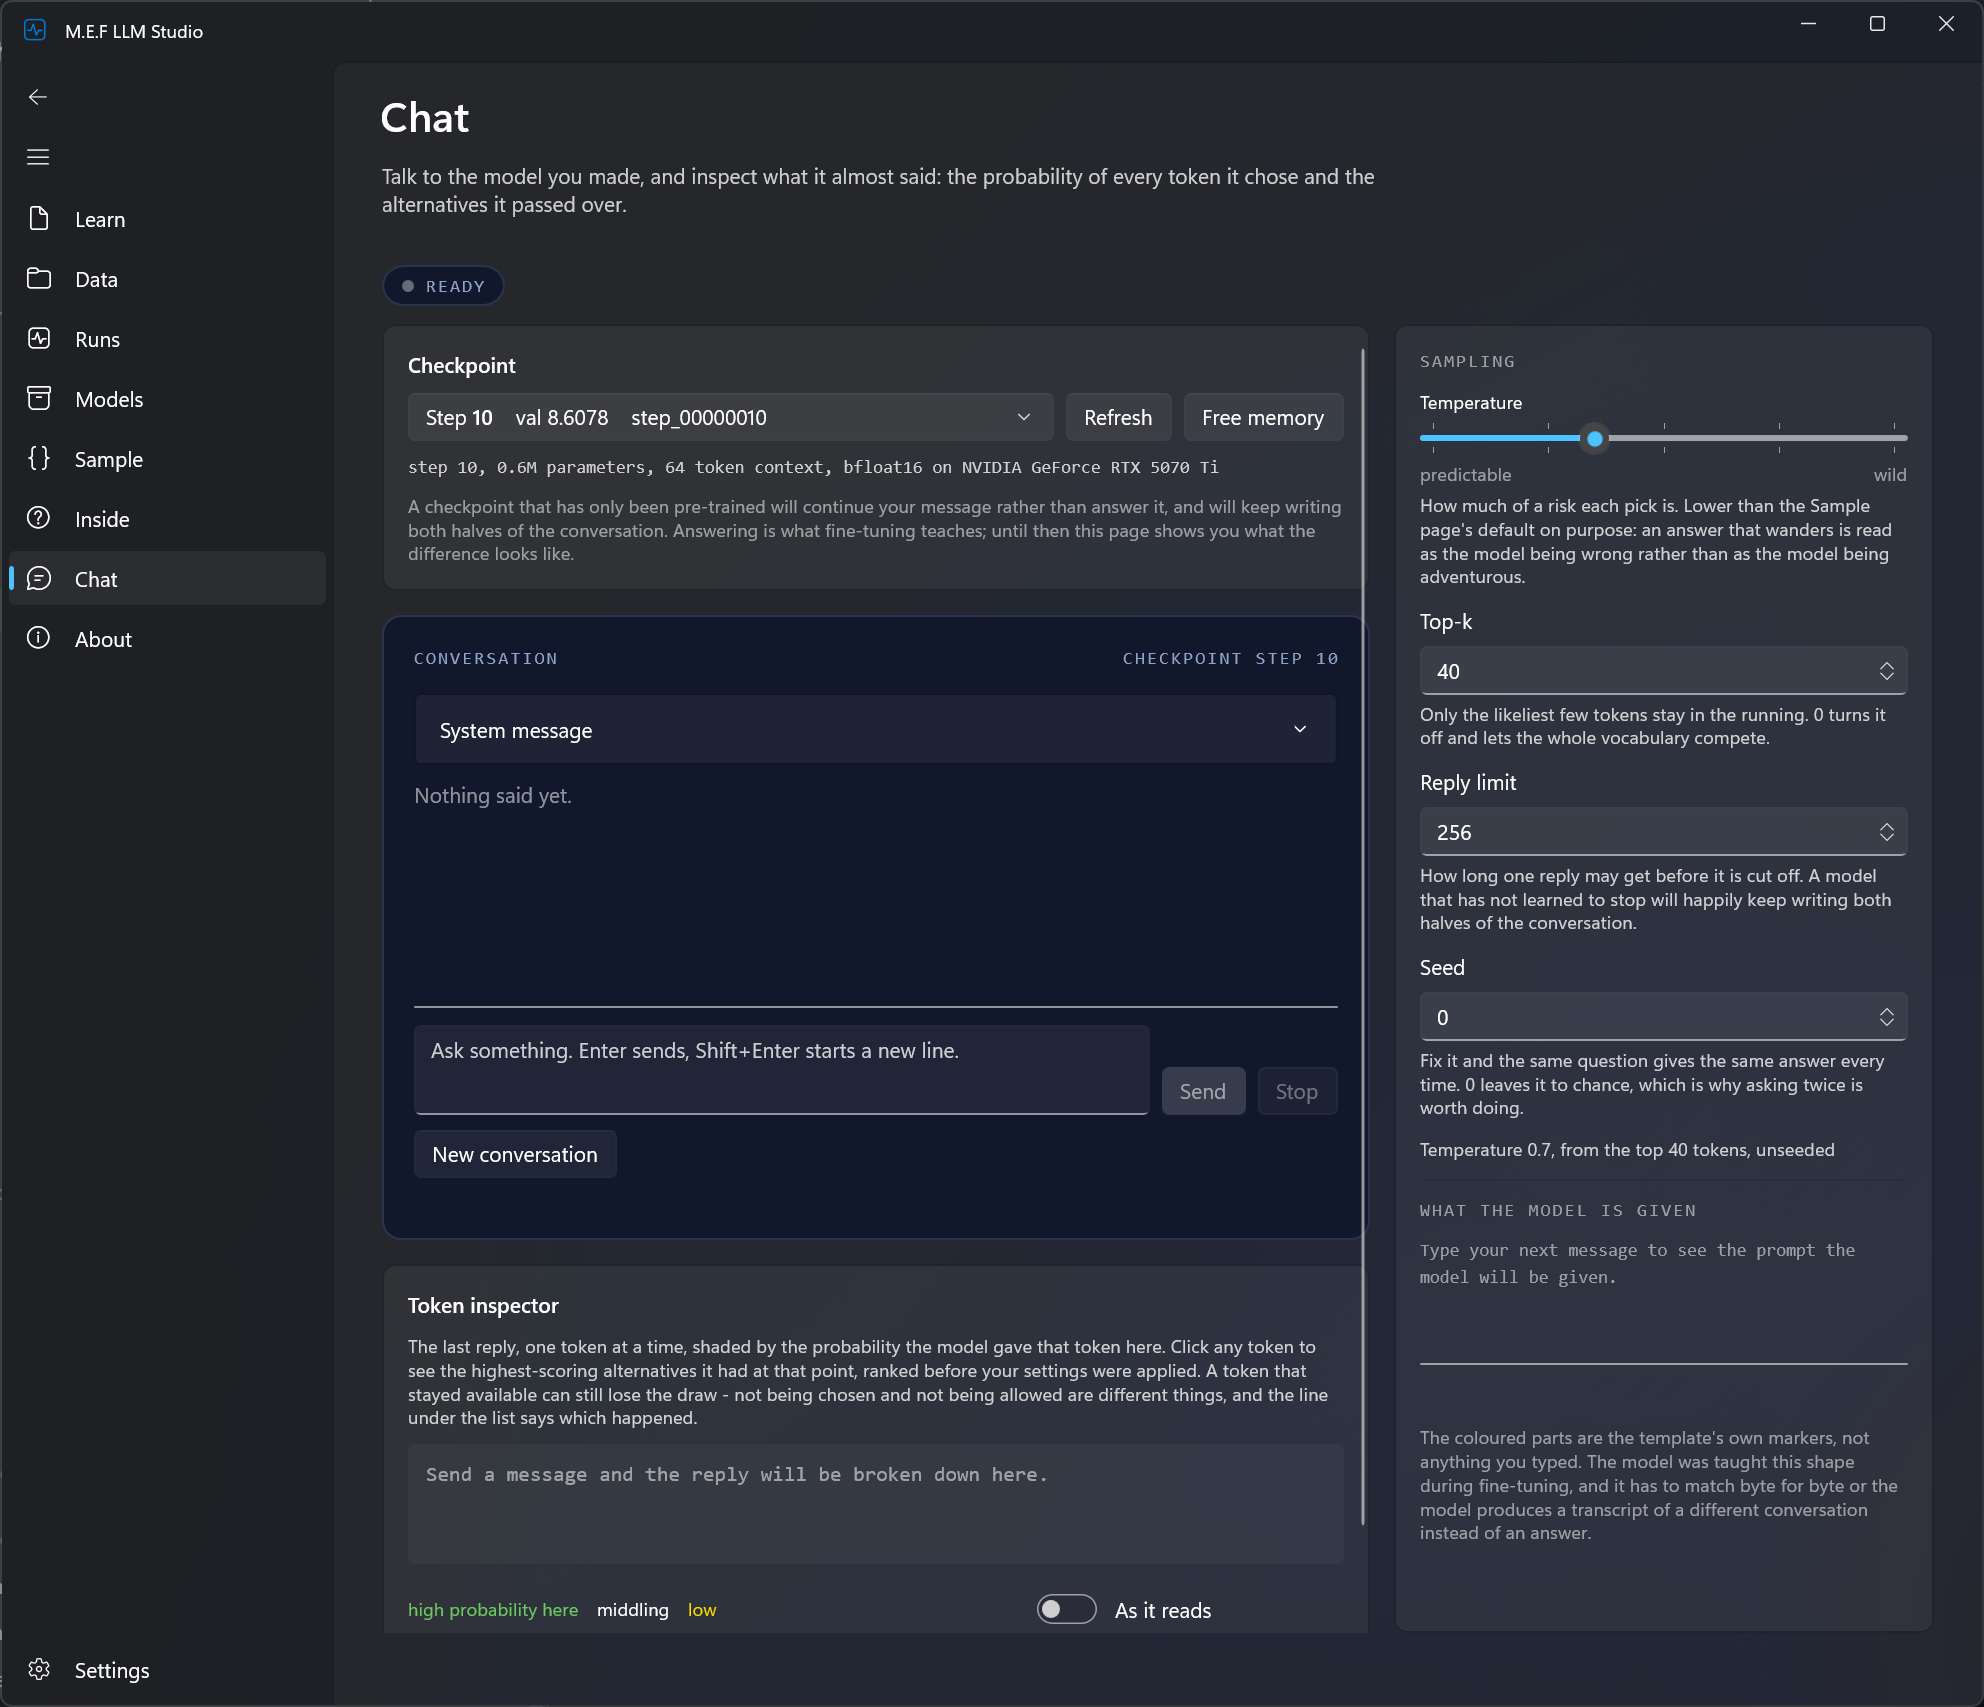
Controlează generarea
Temperatura, Top-k, limita răspunsului și seed-ul influențează generarea textului.
Ce poți face:
Compară setările. Un seed fix permite experimente repetabile în aceleași condiții.
Captură completă a ferestrei ↗Visual Explorer: exemple și proveniență
Vizualizare suplimentară bazată pe Transformer Explainer (Polo Club of Data Science), adaptată pentru calcule înregistrate în M.E.F LLM Studio. Transformer Explainer ↗
De la token la probabilitate.
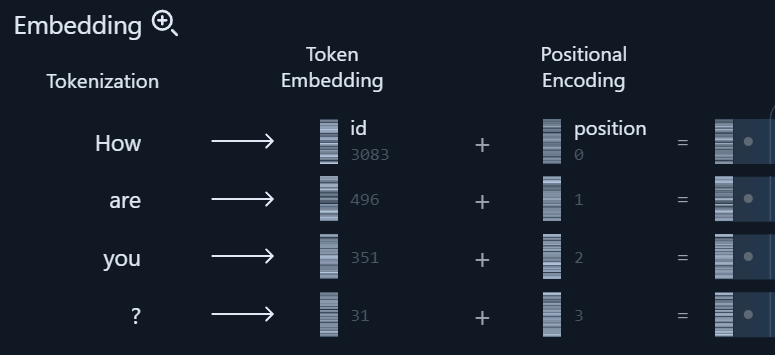
01Embedding
ID-uri de token și informația pozițională înaintea primului bloc Transformer.
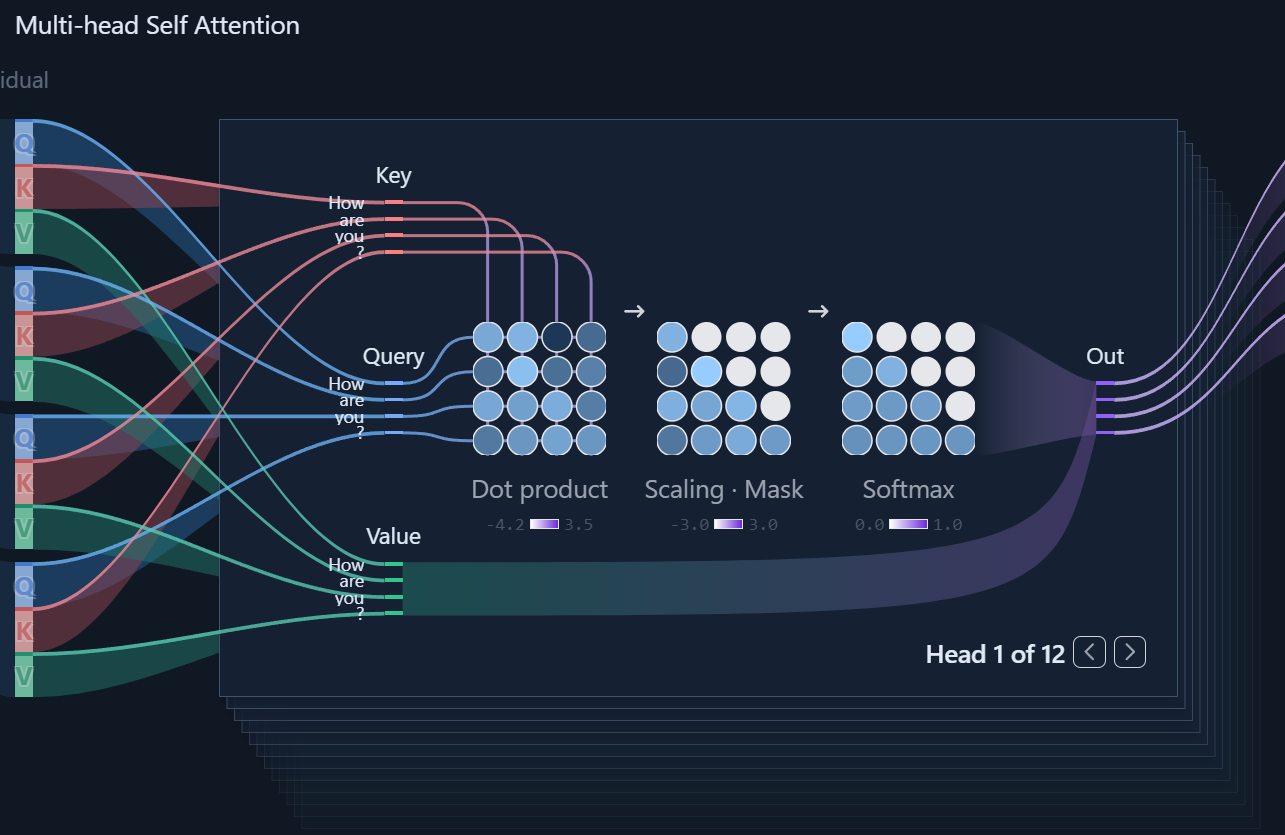
02Attention în detaliu
Produs scalar, scalare, mască cauzală și Softmax în context.
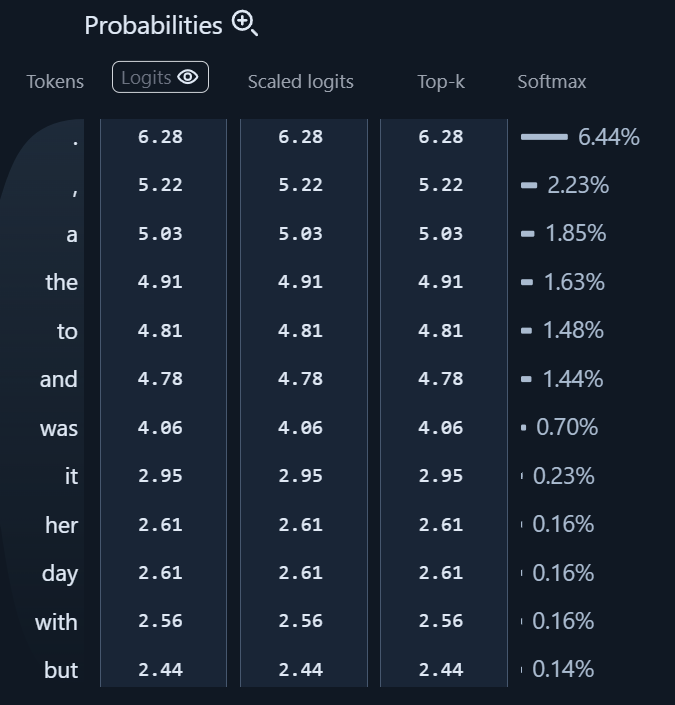
03Probabilități de ieșire
Logits și distribuția Sampling pentru următoarele tokenuri posibile.
Capturile folosesc interfața în limba engleză. Este o vedere din aplicație, nu inferență în browser; valorile aparțin înregistrării exemplu afișate.